La safety es una de las pocas funciones empresariales que todavía hoy mide principalmente los incidentes.
En la manufactura moderna, casi todas las funciones empresariales se han vuelto data-driven.
La producción monitoriza continuamente el OEE (Overall Equipment Effectiveness) para medir disponibilidad, rendimiento y calidad de las instalaciones. El mantenimiento trabaja con el MTBF (Mean Time Between Failures), el downtime, el condition monitoring y el predictive maintenance. La cadena de suministro mide el lead time, el OTIF (On Time In Full), la precisión de las previsiones y la estabilidad de los flujos logísticos.
La safety, en cambio, se basa en indicadores consolidados como:
- TRIR (Total Recordable Incident Rate): mide el número total de accidentes registrables en relación con las horas trabajadas.
- LTIFR (Lost Time Injury Frequency Rate): mide la frecuencia de los accidentes que conllevan ausencia del trabajo.
- Recopilación de near miss, auditorías y observaciones de comportamiento.
- Otros KPI de HSE tradicionales.
Todas ellas son herramientas correctas y fundamentales para el cumplimiento normativo, el reporting y el benchmarking. Pero estos indicadores tienen una limitación estructural muy importante: en la mayoría de los casos observan eventos que ya han ocurrido, o dependen en gran medida de la observación humana y de la calidad de la notificación.
Miden el resultado final del riesgo, pero a menudo no permiten observar de forma continua cómo se está formando el riesgo operativo dentro de la planta.
Y es aquí donde surge una de las grandes paradojas de la seguridad industrial moderna: la safety es probablemente una de las pocas funciones empresariales que todavía hoy mide sobre todo los eventos de fallo.
El problema de los KPI de safety tradicionales
Las limitaciones de los indicadores de safety tradicionales no tienen que ver con su utilidad —que sigue siendo central— sino con su capacidad de describir de forma continua y dinámica el riesgo operativo real.
1. Los incidentes son eventos tardíos
Los incidentes representan casi siempre el resultado final de una larga secuencia de condiciones operativas, exposiciones al riesgo, adaptaciones y comportamientos que se desarrollan mucho antes del evento.
Por este motivo, KPI como el TRIR o el LTIFR resultan fundamentales para medir los resultados, pero son estadísticamente débiles como herramientas para interpretar en tiempo real la evolución del riesgo operativo.
Observar solo los incidentes significa, de hecho, analizar el problema cuando el sistema ya ha mostrado una criticidad.
2. Muchos indicadores dependen de la observación subjetiva
Auditorías, observaciones de comportamiento, checklists y near miss son herramientas indispensables para la cultura de la seguridad. Sin embargo, su eficacia depende inevitablemente de la sensibilidad de las personas y del modo en que los eventos se clasifican y se notifican.
Dos plantas de la misma empresa pueden así registrar datos muy diferentes aun teniendo niveles de exposición similares, simplemente porque adoptan enfoques distintos en la recogida e interpretación de la información.
Esto dificulta la construcción de benchmarks realmente comparables o de estrategias de safety plenamente data-driven a nivel corporativo.
Los KPI agregados a menudo no describen el contexto operativo
Dos plantas pueden tener el mismo TRIR pero condiciones operativas completamente diferentes.
Los eventos registrados pueden derivar de:
- dinámicas distintas;
- niveles diferentes de exposición;
- tipologías operativas no comparables;
- riesgos concentrados en áreas específicas de la planta.
El dato final ofrece así una fotografía cuantitativa útil, pero no siempre suficiente para comprender cómo se está desarrollando realmente el riesgo en el contexto operativo cotidiano.
Y aquí surge una pregunta cada vez más central para el mundo de HSE:
Y aquí surge una pregunta cada vez más central para el mundo de HSE: ¿por qué hoy, en un contexto industrial cada vez más digitalizado, no aprovechamos más las tecnologías innovadoras de monitorización continua, la recogida objetiva de datos, la IA y el machine learning para ayudar a los HSE managers a observar de forma más continua y objetiva lo que ocurre realmente en la planta? ¿Por qué no utilizar los datos operativos para identificar patrones recurrentes, monitorizar las dinámicas de riesgo y apoyar estrategias de safety cada vez más data-driven?
El verdadero cambio de paradigma: ¿cómo observar el riesgo antes del incidente?
En la manufactura moderna disponemos ya de enormes cantidades de datos operativos.
Sin embargo, en la safety industrial, gran parte de los análisis sigue basándose principalmente en eventos ya ocurridos, observaciones periódicas y recogidas de datos discontinuas.
Pero la verdadera pregunta hoy ya no es: «¿Cómo registramos mejor los incidentes?»
La verdadera pregunta es: «¿Cómo observamos y cuantificamos continuamente el riesgo antes de que ocurra el incidente?»
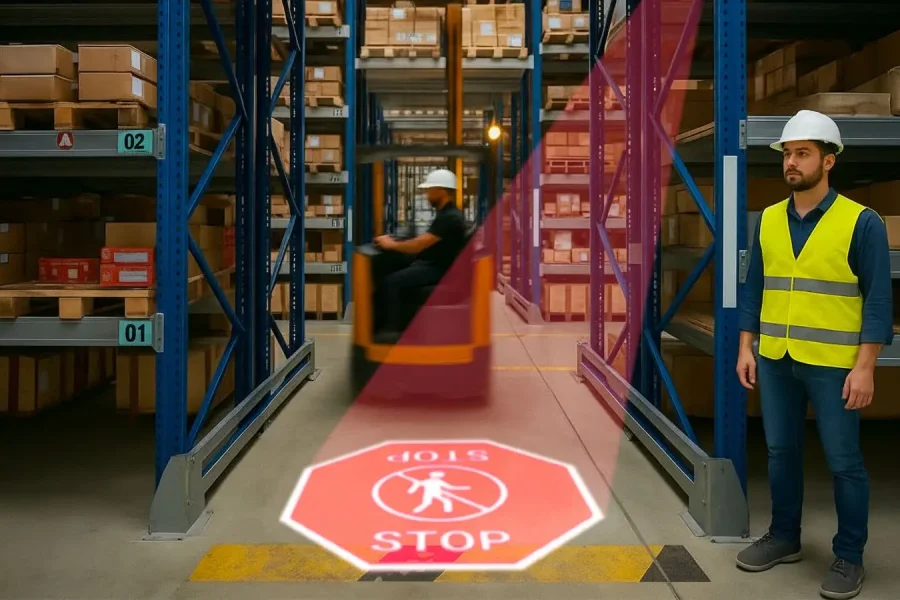
Y es aquí donde está emergiendo el verdadero cambio de paradigma de la safety industrial moderna. Una safety cada vez más continua, observable, contextualizada, que mida no solo los incidentes finales, sino también: los near miss, las interacciones hombre-vehículo, la exposición dinámica al riesgo y los patrones de comportamiento recurrentes.
Porque el riesgo real no aparece de repente en el instante del incidente. Se desarrolla a lo largo del tiempo, dentro de las dinámicas operativas cotidianas normales.
No es casualidad que en los últimos años se hayan difundido enfoques como:
- Behavior Based Safety (BBS);
- Human Factors;
- Human & Organizational Performance (HOP);
- Safety II.
Enfoques que desplazan progresivamente la atención del error final al contexto operativo, y de los eventos individuales a los comportamientos agregados, pasando así del mero análisis del incidente a una observación continua del sistema.
Porque muy a menudo el problema no es simplemente «quién se equivocó», sino qué condiciones operativas están generando sistemáticamente exposición al riesgo.
De la seguridad reactiva al Safety Performance Management
En AME estamos trabajando precisamente en esta evolución a través de un enfoque de Safety Performance Management.
La idea de base es sencilla: transformar la seguridad de un sistema principalmente retrospectivo a un sistema continuo de observabilidad del riesgo operativo.
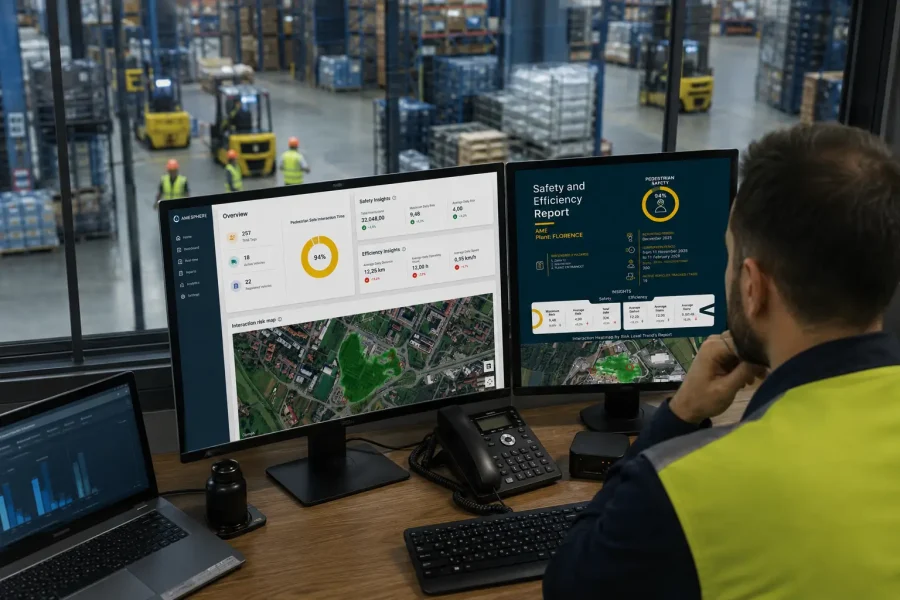
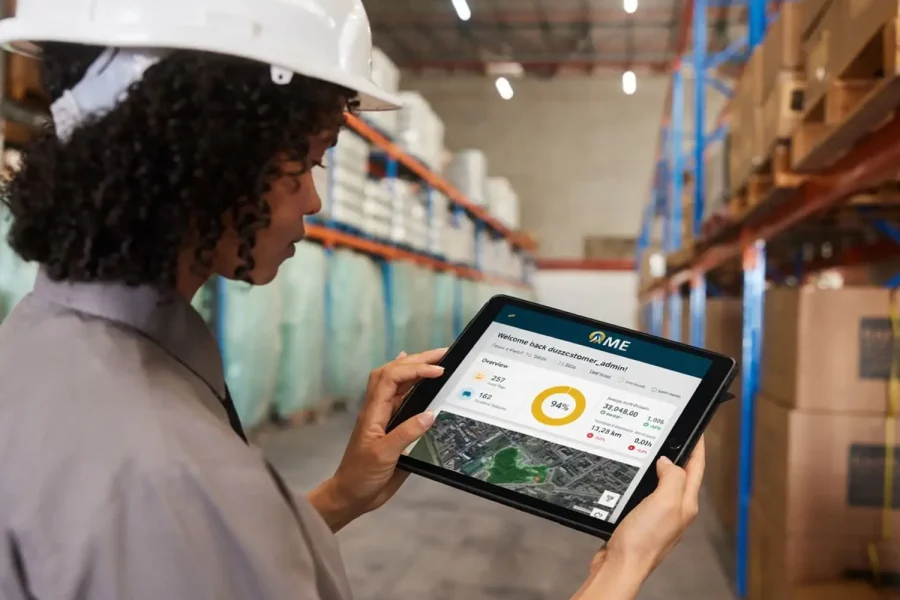
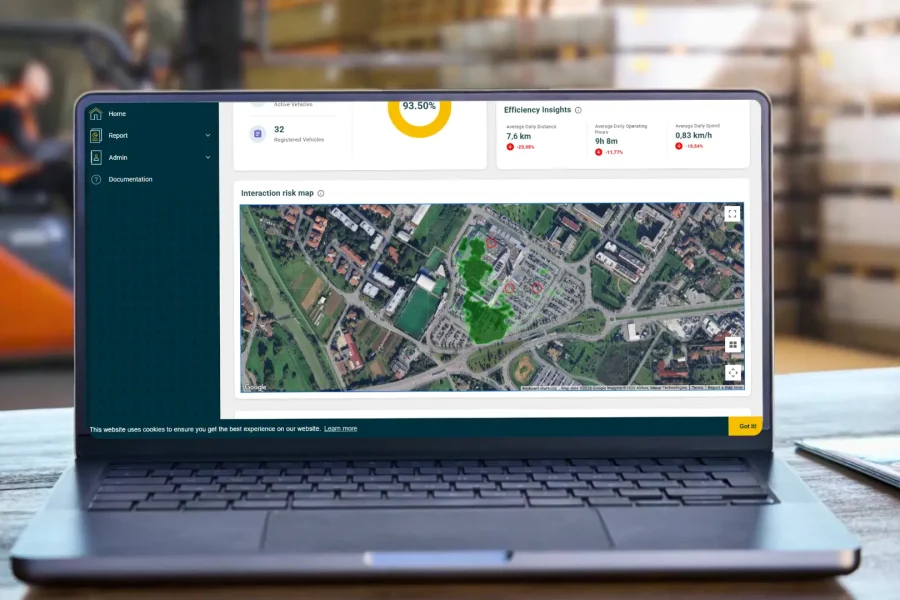
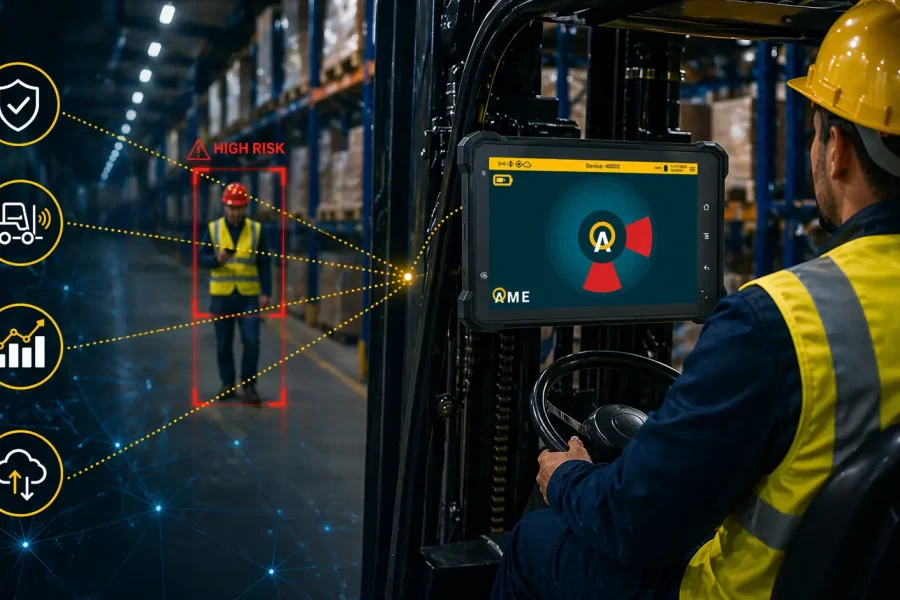
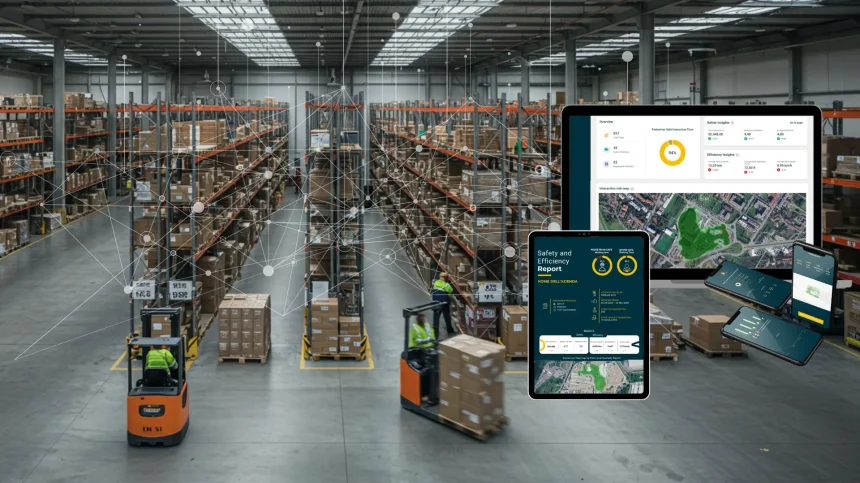
Para ello, AME ha desarrollado AMESPHERE Platform, una plataforma de software diseñada para adquirir y analizar datos operativos continuos procedentes de la planta y de la flota de vehículos industriales.
El objetivo no es recoger más datos de forma indiscriminada, sino transformar datos operativos continuos en información realmente utilizable para los HSE managers y las operations.
La plataforma permite:
- identificar patrones recurrentes;
- comprender dónde tiende a concentrarse el riesgo;
- identificar hotspots operativos;
- monitorizar la evolución de los comportamientos en el tiempo;
- evaluar la eficacia de las acciones correctivas.
A través de algoritmos de IA y machine learning, los datos se procesan y contextualizan para ofrecer a los HSE managers solo los insights realmente útiles, mediante dashboards, KPI avanzados y notificaciones operativas.
El aspecto interesante es que este enfoque no solo permite poner de relieve el riesgo, sino también valorar los elementos positivos de la performance de safety. Por tanto, no solo «cuánto riesgo existe», sino también cuánto tiempo operativo se desarrolla en condiciones seguras y qué procesos resultan más estables y controlados.
Porque una safety moderna no debería limitarse a contar los incidentes. Debería ayudar a las empresas a comprender continuamente cómo está funcionando el sistema operativo.
Conclusión
La manufactura moderna dispone hoy de una enorme cantidad de datos operativos. Sin embargo, la safety sigue estando demasiado a menudo ligada a lógicas retrospectivas y a observaciones discontinuas.
El objetivo no es sustituir la experiencia de los HSE managers ni la cultura de la seguridad. Al contrario: el objetivo es reforzar el papel de HSE proporcionando herramientas más continuas, comparables y objetivas para leer el riesgo operativo real. Porque la experiencia, el conocimiento de la planta y la capacidad de interpretación siguen siendo centrales. Pero hoy pueden estar respaldadas por una nueva generación de datos y herramientas analíticas.
Esta es la dirección en la que estamos trabajando en AME: transformar la safety de una función principalmente reactiva a un sistema continuo de observabilidad y mejora operativa. Porque la pregunta estratégica ya no debe ser: «¿Cuántos incidentes hemos tenido?», sino más bien: «¿Cuánto riesgo operativo estamos generando cada día?»
Descargar el artículo en PDF